AI在基础科学与材料发现中的应用
探讨大模型与自动化实验在物理、材料科学等基础科研领域的突破与落地闭环
1个信源参与该主题的先锋
全部段落
10月23日
10月21日
10月19日
10月17日
10月15日
10月9日
10月8日
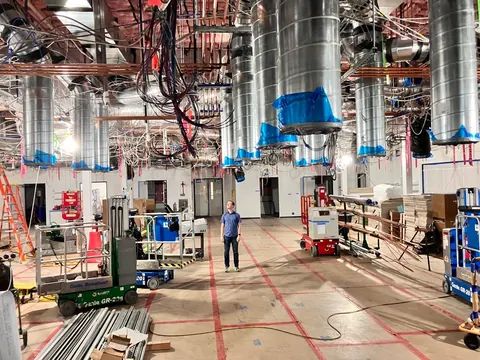
- Liam Fedus Periodic 押注,前沿科学 AI 只有在其猜想必须经由仿真、高通量实验和带噪声的物理测量验证时,才能真正发挥价值。 Fedus 将这一前提概括为“不能只靠思考找到答案”:论文和预训练知识可以生成假设,但现实才会提供决定性证据。这家公司更像现代 Bell Labs:化学家、物理学家、实验科学家、硬件工程师和 LLM 研究人员围绕同一条闭环协作。
- Periodic 真正的核心技术资产,不只是实验数据,而是带时间戳的全链路脉络,记录完整科研项目如何从失败尝试推进到可行工艺。 其中包括计算结果、仪器数据、代码、讨论、直觉、负面结果以及最终成功——这些信息大多会从已发表文献中消失。Fedus 的区分非常关键:Periodic 要训练的是“做科学的过程”(“on the process of doing science”),而不只是科学最终产出的结果,从而 …
- Ekin Dogus Cubuk Periodic 认为,材料发现规模化的主要瓶颈在于自动化表征,而不只是把更多粉末混在一起。 X 射线衍射图谱可能包含多个相,不同结构也可能匹配同一信号;合成出的材料和失败实验同样不会自带标签。AI 的价值在于结合热力学、化学可行性、重复实验、电学与磁学测量、显微镜数据及纵向证据;Cubuk 的简洁解释是,在人类上下文能力有限的地方,系统可以“把一切都看进去”(“look …
- Liam Fedus 实验室自动化优化的目标是数据量、质量和可复现性,而不是展示人形机器人,或为了自主而自主。 Periodic 将理解上下文的智能直接部署到仪器上;当现成设备造成瓶颈或污染风险时,公司会重新设计硬件;在处理高难度灵巧操作前,先把常规工作自动化。Fedus 明确表示,“完全自主不是目标”;一个系统已经通过发现循环置换和反转可以让完整数据集重新一致,诊断出一台装载错误的机器。
- 近期商业切入点是向半导体公司提供安全的现场部署,长期则从研究员副驾走向按结果收费。 现场部署团队在客户本地集成 AI 与仿真系统,用合作方数据训练模型,让客户“拥有自己的智能”,而不是把专有信息发送给通用 API。Fedus 所称的“物质编译器”是更远期的目标:输入材料目标状态,系统判断它是否能够存在,以及应如何合成。
- Ekin Dogus Cubuk 更多仿真算力无法替代实验室,因为完美晶体、近似理论和无法观测的物理状态都会遗漏决定真实材料表现的变量。 Cubuk 援引“越多越不同”(“More is different”):即使掌握微观层面的基本定律,强关联体系、微结构、动力学和高温超导仍不容易计算。即便进行1亿次密度泛函理论试验,也无法检验真实微结构;而科学发现“几乎按定义就是你没有训练过的东西”(“almost by …

- Latent Space Periodic Labs 的核心押注是,单靠智能无法创造物理知识。 公司的行动准则是:“智能是必要条件,但不是充分条件;只有当想法被证实与现实一致时,新知识才会产生。” 因此,公司将 AI、模拟系统和高通量实体实验室作为一个迭代系统共同打造:提出猜想、合成、表征、更新,再重复这一过程。
- 物理科学需要不同于数学或编程的 AI 范式,因为观测带有噪声、不完整、昂贵且缓慢。 炉体会老化,温度随位置变化,振动会干扰光学设备,实验完成后的样品也不会自带标签;与数字环境不同,Periodic 无法无限生成 rollout。核心约束是如何在不确定性下决策,以及如何实现极高的样本效率:“科学非常困难,但这正是它特别之处。”
- Periodic 真正可能形成差异化的资产,不只是实验数据,而是带时间戳的科学工作过程谱系。 公司记录失败尝试、计算、代码、对话、直觉、仪器读数,以及一项实验如何从反复得到阴性结果走向最终阳性结果的完整路径。这使模型能够基于证据和带时间戳的状态训练,而不是简单依赖预训练模型已经记住的答案,将目标从“科学的最终产出”转向“做科学的过程”。
- 短期杠杆最大的瓶颈是自动化表征,而不是人形机器人。 混合粉末相对容易;识别实际生成了什么、对齐多个仪器的结果并选择下一项实验,才限制了吞吐量。Periodic 所说的“每台设备……140 IQ”,指的是能够理解上下文、采集更好数据的仪器,而“完全自主并非目标”:自动化服务于数据的数量、质量和多样性。
- 模拟是高通量筛选器,而不是现实的替代品。 密度泛函理论可以估算材料稳定性,但实际近似方法难以处理强关联、微观结构以及超导温度等性质;即使完成1亿次完美晶体计算,也无法揭示每个真实样品的缺陷和中尺度结构。Periodic 的答案是让模拟、AI 和实验形成校准闭环,而实验室仍是“最终真相”。
- 规模化需要同时投入实验室、算力、仪器,以及一支罕见的跨学科组织。 标准设备最终会暴露吞吐瓶颈和污染风险,迫使公司定制硬件;增加实验室也能接触不同的专业能力和实验条件。组织模式则刻意把固体化学家、物理学家、实验人员、理论人员、AI 研究员、基础设施工程师、硬件开发者和产品团队放在一起,因为这本质上是一个“不可再拆分的跨学科问题”。
10月3日
10月2日
9月22日
- John Platt Platt 认为,ERA 直到最近 Gemini 的能力提升后才真正变得可用。 他表示,在 Gemini 2.0 时代,“这是不可能做到的”;而在实验开始奏效后,Gemini 各个大版本和中间版本的进步都十分显著。他回忆说,Gemini 2.5 已经能立即写出 boosted-decision-tree 代码,并告诉那些不喜欢 2.0 的科学家:那已经是“上 …
- ERA 的核心洞见是,许多科学问题都可以转化成“可评分任务”:编写代码,最大化一个预先定义的分数。 它的 Monte Carlo 研究循环借助 Gemini 改写 notebooks;Gemini 能阅读论文、提出代码,并利用有助于构建模型的“梯度”。随机改写代码基本以失败告终,因为大多数变异都有害;LLM 作为变异算子,则能做出更有信息量的修改。
- 人类仍必须定义目标,并持续监督目标是否被正确执行。 评分函数可能存在漏洞,agents 和人类都会通过钻漏洞来刷分。Platt 举例说,Kaggle 参赛者曾在一个卷云竞赛中发现标签存在半个像素的误差。他表示,研究人员既需要创造力,也需要严谨性;人类必须确认优化后的结果确实是在描述现实,而不只是预测得准。
- 持续性航迹云约占人为全球变暖的1%,而且或许可以用相对低的成本规避。 冰过饱和区域可能把排放的水、冰或烟尘效应放大约10,000∶1;避开这些区域有时只需下降两个飞行高度层。ERA 还找到一个简单的反事实模型,解决了 Platt 的团队曾经卡了两年的反射阳光问题。
- Platt 认为,具备商业意义的核聚变可能“3年后,而不是30年后”实现,但他强调这只是概率判断,并非确定预测。 Lawson 判据要求密度、温度和约束时间的组合超过阈值,而每种路线都有自己的阿喀琉斯之踵。他还强调,电气化和电池并不能提供一个适用于所有场景的气候解决方案。
- 天气预报已经经历了一次机器学习带来的重大跃迁,而气候问题仍然难得多。 天气预测的是大气的演化轨迹;气候关注的是一个本身也在变化的吸引子的统计特征。由于未来数据有限、碳循环行为存在巨大不确定性,Platt 希望未来的系统能把数据与散落在大量论文中的科学知识结合起来,但他表示 ERA 目前还做不到这一点。