AI训练数据与评测基准
聚焦高质量训练数据、防作弊评测与强化学习环境
4个信源 · ↑1.1×参与该主题的先锋
全部段落
10月27日
10月26日
10月25日
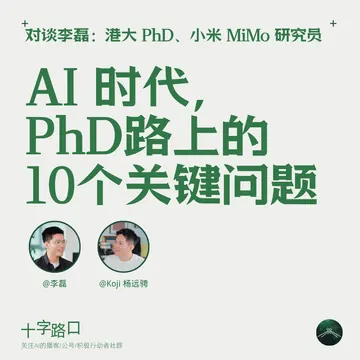
- 李磊 数据公司的长期价值,取决于能否持续补上模型的新短板。 李磊认为,需求会持续存在;如果数据公司不能持续产出高质量数据,模型自身产数能力提升会让成本降得很低、竞争更加激烈。能识别能力缺口、组织专家并规模化交付的pipeline,优势反而可能扩大。模型公司购买数据,也是购买推进智能前沿的时间;他称“时间是不可逆的资源”。
- 小米的后训练直播把大规模RL的训练动态与成本推到了公众面前。 李磊称,团队早期训练时看到大规模RL能带来“非常全面”的能力提升,希望借MiMo V2.6的Pro、Flash两款模型,给行业做RL的信心。国内反馈集中在费用,海外反馈更关注透明度;近乎公开TensorBoard,也让研究者获得分析训练dynamics的“金矿”。
10月20日
- Andrej Radonjic Grass 的优势,始于让 AI 系统能够访问屏蔽数据中心流量的网站。 Andrej Radonjic 表示,通过住宅 IP 路由是广泛获取网站内容的最佳方式,浏览器基础设施还能应对额外防护。Grass 向自愿参与者购买带宽;Andrej 称,Grass 已向 AI 实验室交付艾字节级数据。
- Delphi Digital 前沿实验室采购数据时,越来越看重有效信号和交付速度,而不只是原始数据量。 实验室的筛选过程可能发现,数据集中只有一小部分有用——例如 0.16%——从而转向更有针对性的采购。新模型每隔几个月就会刷新基准,客户可能因此“落在后面”;成熟实验室会根据基准提升、后续 token 使用量和财务回报来评估数据价值。
- 机器人领域需要经过精挑细选的行为视频。 Andrej 将 Yan 提到的约 10 亿个公开视频更新为已索引超过 1000 亿个。Yan 指出,索引不等于把每个视频都下载下来。生成式视频受益于多样、可组合的样本;机器人目前需要能教会模型动作和互动的视频素材,筛选难度远高于单纯累积视频。
- Andrej Radonjic 训练爬取正在为实时推理和搜索搭建基础设施。 Andrej 将训练数据采集形容为一场“寻宝”,同时也在绘制互联网地图。Grass 已在 Live Context Retrieval 旗下发布 Content API,下一步计划推出 Search;他预计训练数据和推理数据最终会逐渐融合。
- Delphi Digital Yan 转述了一位创业者的观点:更高的再投资回报可以构成护城河,Andrej对此表示认同。 Yan 提到,市场预计到 2030 年 AI 数据市场将达到 1000 亿美元;Andrej 认为,合成轨迹、强化学习和其他数据类别都存在扩张机会。收尾的护城河讨论聚焦于如何比竞争对手更有效地利用每一美元。
10月19日
10月17日
10月14日
- Nathan Lambert 在较难验证的领域,前沿进步很大程度上来自高质量数据和环境,而不只是“突然就泛化了”。 Lambert 认为两方面因素可能都有,但很大一部分归根结底是数据。他对环境研究预算的规模感到咋舌,但也指出实验室愿意买,是因为模型确实因此变强。这场淘金热也催生了数据供应链下游的偷工减料和奖励作弊。一个值得关注的投资细节是:中国公司可能买下一个RL环境,6个月后才投入使用。
- 他新成立的非营利机构 Trillium 将开发开源环境,并公开研究和模型使用过程——任务、配置、轨迹和失败案例——让RSI不再神秘。 这个名字本身就是理念:Trillium 是一种“春季短暂花”,能在树冠长成前开花,并帮助养分扩散。Lambert 希望为这个行业建立开放基础设施;在这个行业里,“计算机科学研究的收益,大约10年后会流向科技行业”,而研究人员创办初创公司后,“5个月内就可能拿到九位数回报”。
- SemiAnalysis GLM-5.3 能力跃升,据称来自后训练,而不是更大的基础模型。 Wenyao称,智能体基准提升超过10%;Kimbo认为,GLM-5.2 到 GLM-5.3 在网络安全能力上的变化“判若云泥”。Jordan称 GLM-5.3 是“前沿网络安全模型”,依据是他在 CVP 威胁攻防演练工作中遇到 Anthropic 和 OpenAI 拒答,随后转 …
- Kimbo Chen Z.ai 的优势或许不只在新算法,也在研究推进速度。 Jordan提出,常见后训练方法并非独家优势;在相同算力下,以更低成本跑更多实验,也能形成优势。Kimbo提到基于 critic 的 SAO 训练和 SLIME,称后者“可以说是设计最好的”框架之一;不过,他也提醒,GLM-5 之后尚未发布详细技术报告。
10月13日
10月8日
10月5日
9月28日
- 何允中 行业需求重心在从人工标注转向rubric(评分细则)和RL environment(强化学习环境)。 Scale AI的何允中入职时rubric data还很新,"现在Rubric感觉已经过时了,大家都在讲RL environment";但他也强调pre-training仍然重要。核心逻辑是weak-to-strong supervision——让专家把打分规则写下来,弱模型"拿 …
- 孙一铀 两位嘉宾在rubric是否到头上公开分歧,这是判断赛道存量的关键信号。 允中认为比较容易获得的专家Rubric已经收得比较干净,尤其是静态、单轮或多轮文本输出的需求相对变小;伯克利的孙一铀反驳"Rubric这一块……其实还远远不够"——专家主观判断(游戏好不好玩、公司决策好坏)还没有成型的量化评测体系,而这可能是未来的需求。
- 硅谷101 Benchmark与卖数据不能混为一谈。 一铀称私下听说有数据公司把自己正在用于评测的数据拿去卖,并敲响警钟:不能让生意污染Benchmark的权威性;他的框架是"Benchmark面向的是未来,数据面向的是现在"。只要榜单贴近真实用户体验,"Bench-maxxing不一定是贬义词"。
- 在垂直领域,采购正成为重要卡点和创业机会。 一个玩家只有几千人的MOBA游戏,源码要价能到两三百万元人民币一条;芯片设计要解决商业软件版权,有公司据称做了整套AWS模拟器;ALE V2用Nature子学科分类展开到第三级约3000个节点,发现现有生物类Benchmark覆盖率"可能10%、5%都不到"——医疗等敏感垂类"谁 …
- 允中的"暴论":大模型实验室未必有最好的基因解决数据问题,数商的真正护城河是研发。 如果一边把FDE派进企业、一边收集该企业数据,可能产生利益冲突,企业"不太放心把数据交给你";好数商应该像软件公司一样提前投入R&D、把行业问题研究清楚再卖给deadline很死的lab,最终"拼的还是一个研发能力",谁能把研发固化成flywheel谁赢。
- 何允中 数据造假比数据污染更难防,激励机制设计是尚未解决的巨大研究领域。 公开数据污染相对容易检测,但专家编造的化学模拟"没有个几个月根本查不出来",验证专家本身也可能偷懒——"众包的Benchmark为什么难做,就是难做在这里,人性非常复杂";OpenAI今年2月停报SWE-bench Verified分数,何允中印象中该榜过去6个月只从74%涨到 …